Af Greg Nowak. Opdateret 22. august 2026.
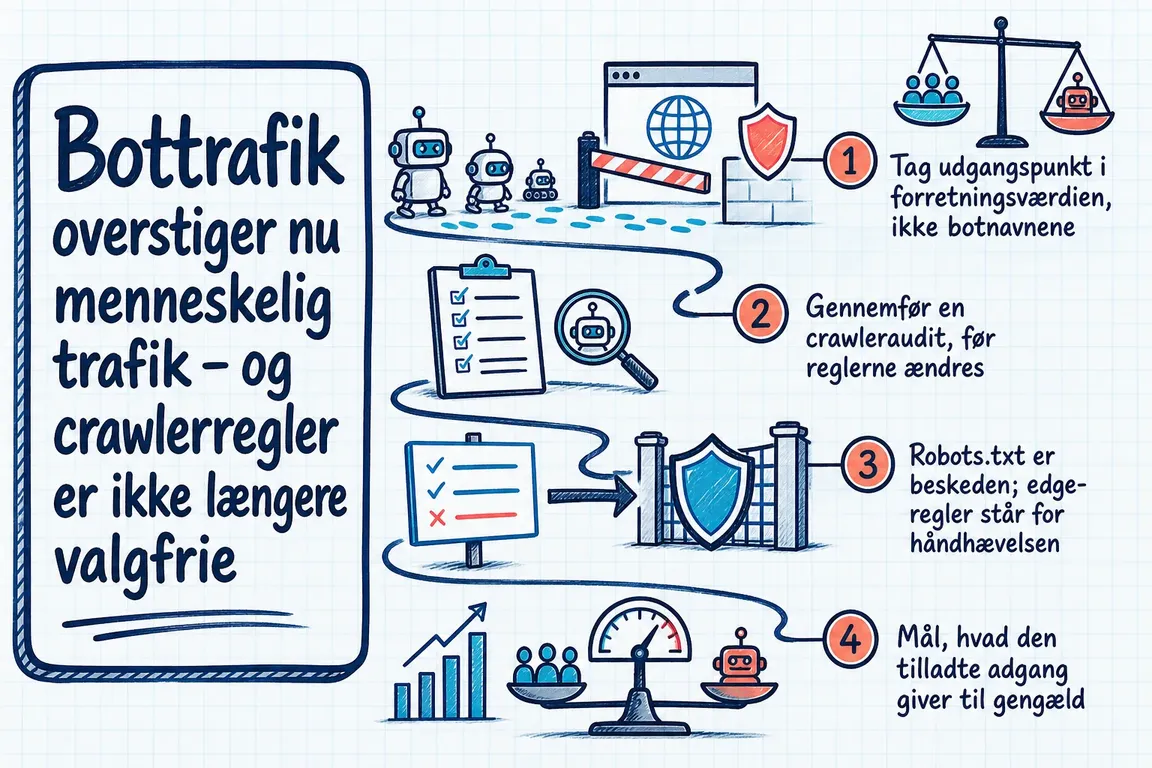
Automatiseret trafik har passeret en væsentlig tærskel. I juni viste Cloudflare-data omtalt af Tom’s Hardware, at bots stod for 57.5% af HTTP-forespørgslerne og mennesker for 42.5%. Det betyder ikke, at AI-systemer nu udgør størstedelen af internetbrugerne: Målingen tæller forespørgsler, ikke personer, opmærksomhed eller omsætning. Den omfatter desuden bottrafik generelt og giver ikke en entydig subtotal for AI alene.
Den forretningsmæssige betydning er stadig væsentlig. Websites bliver i stigende grad læst af søgecrawlere, træningscrawlere, AI-assistenter, shoppingagenter og mindre velkommen automatisering. En generel tilgang, hvor man enten ”tillader alt” eller ”blokerer al AI”, vil næppe gavne alle dele af et kommercielt website.
En brugbar crawlerpolitik besvarer tre spørgsmål: Hvilke automatiserede besøgende må tilgå hvilket indhold, hvilken værdi forventer virksomheden til gengæld, og hvordan håndhæves og revideres beslutningen?
Tag udgangspunkt i forretningsværdien, ikke botnavnene
Begynd ikke med at kopiere en andens blokeringsliste for crawlere. Begynd med at klassificere sitet. Offentlig dokumentation, leadgenererende sider, produktdata og licensbelagt research har forskellig økonomi, selv når de ligger på samme domæne.
| Indholdsområde | Fornuftigt udgangspunkt | Dokumentation, der bør gennemgås |
|---|---|---|
| Marketing- og servicesider | Tillad anerkendte søge- og assistentcrawlere | Kvalificerede henvisninger, omtaler og konverteringer |
| Dokumentation og support | Tillad selektivt, og overvåg omfanget | Henvisningsdestinationer, supportresultater og båndbredde |
| Produkt-, pris- eller lagerdata | Gennemgå hver sti individuelt | Kommerciel synlighed over for genbrug eller overdreven polling |
| Original research eller premiumarkiver | Bloker som udgangspunkt, eller vurder licensering | Efterspørgsel fra crawlere, indholdsomkostninger og eksisterende aftaler |
| Login-, søge- og kontoområder | Begræns unødvendig crawling | Sikkerhedslogs, serverbelastning og mislykkede forespørgsler |
Registrér en ansvarlig og en begrundelse for hver undtagelse. ”Tilladt, fordi det måske kan være nyttigt” er ikke en holdbar politik; det er ”tilladt i offentlig dokumentation, mens henvisninger og forespørgselsvolumen gennemgås månedligt” derimod.
Gennemfør en crawleraudit, før reglerne ændres
Cloudflares AI Crawl Control er tilgængelig på tværs af virksomhedens abonnementer og kan vise crawleraktivitet efter operatør, hostname og sti. Den aktuelle dokumentation fremhæver også en vigtig begrænsning: På gratisabonnementet bygger registreringen på selvdeklarerede user-agent-strenge, mens mere avanceret registrering kræver Bot Management. Betragt dashboardet som operationel dokumentation, ikke som en fuldstændig optælling af alle automatiserede forespørgsler.
- Kontrollér, at hvert hostname i produktion leverer en gyldig
/robots.txt. - Eksportér eller registrér de mest aktive crawlere, de forespurgte stier, svarkoder og overførte bytes.
- Adskil AI-træningscrawlere, AI-assistenter, søgecrawlere og uidentificeret automatisering, hvor de tilgængelige data gør det muligt.
- Sammenhold tilladt crawling med henvisninger, leads eller andre nyttige resultater.
- Undersøg pludselige stigninger i antallet af forespørgsler, gentagen hentning og adgang til omkostningstunge eller kommercielt følsomme endpoints.
AI Crawl Control-målinger på gratisabonnementet dækker i øjeblikket højst et vindue på 24 timer. Virksomheder, der har brug for et længere sammenligningsgrundlag, bør derfor supplere dem med eksisterende data fra CDN, webserver eller analytics. Når disse data er tilgængelige, er 30 dage en praktisk første analyseperiode.
Robots.txt er beskeden; edge-regler står for håndhævelsen
Et direktiv i robots.txt meddeler dine præferencer til en navngiven crawler. Det autentificerer ikke afsenderen og gennemtvinger ikke efterlevelse. Cloudflare kan overvåge forespørgsler til stier, der ikke er tilladt, og håndhæve beslutninger via sin Web Application Firewall, herunder stispecifikke undtagelser.
Kontrollér både den offentliggjorte fil og det svar, som en identificeret crawler modtager:
curl -i https://example.com/robots.txt
curl -I -A "CrawlerUserAgent" https://example.com/research/sample-page
Erstat user agent og sti med faktiske værdier fra den relevante operatørs aktuelle dokumentation og jeres politik. En simuleret user agent tester kun det svar, der er knyttet til denne deklaration; den dokumenterer ikke, hvordan stærkere signaler til botverificering vil klassificere en reel forespørgsel.
Cloudflares rapportering af overtrædelser kræver tilsvarende omhyggelig fortolkning. Den sammenholder de nuværende direktiver med historiske forespørgsler, så en regelændring i dag kan få ældre forespørgsler, som tidligere var tilladt, til at fremstå som overtrædelser. Kontrollér tidsforløbet, før en tilsyneladende overtrædelse eskaleres.
Mål, hvad den tilladte adgang giver til gengæld
Det samlede antal forespørgsler fortæller ikke i sig selv, om adgangen er umagen værd. Gennemgå de mest efterspurgte stier, båndbredde, statuskoder og crawleroperatører sammen med henvisninger og efterfølgende forretningsaktivitet. Cloudflares betalingsabonnementer kan levere analytics for AI-henvisninger, men almindelig webanalyse og CRM-attribution er fortsat nyttige til at kontrollere, om besøg fører til henvendelser, salg eller produktbrug.
Det forebygger to kostbare fejl: at blokere en assistent, som hjælper potentielle kunder med at finde jeres ydelser, eller at levere store mængder værdifuldt indhold til en crawler uden noget synligt afkast. Ikke alle gevinster viser sig som et almindeligt klik, så kombinér kvantitative data med kommercielle aftaler, synlighed gennem omtaler og indholdets strategiske formål.
Behold Pay Per Crawl i kategorien for eksperimenter
Cloudflares Pay Per Crawl udvider valgmulighederne fra tillad eller bloker til tillad, opkræv betaling eller bloker. I august 2026 er løsningen dog stadig i lukket beta – ikke en pålidelig indtægtskilde, som en crawlerstrategi bør baseres på.
For kvalificerede sites vil en fornuftig test begynde med en klart afgrænset sektion af høj værdi, mens sider til opdagelse fortsat er tilgængelige. Fastlæg det omfattede indhold, prishypotesen, hvilke crawlere der er kvalificerede, den regnskabsansvarlige og succeskriterierne, før betalingssvar aktiveres. Eksisterende WAF-blokeringer har fortsat forrang, så betalingsmodellen skal udformes som en del af det samlede regelsæt.
Gør crawler-governance til en løbende vedligeholdt forretningspolitik
Udpeg én ansvarlig ejer, underlæg reglerne ændringskontrol, og gennemgå dem hvert kvartal eller efter en væsentlig ændring i trafikken. Marketing bør definere værdien af synlighed, redaktionelle teams eller produktteams bør klassificere indholdet, og den tekniske drift bør implementere og overvåge kontrollerne. Juridisk bistand kan være nødvendig til formuleringer om licensering, men bør ikke erstatte teknisk håndhævelse.
Hvis dashboardet er fyldt med botnavne, men ingen kan forklare, hvad der bør tillades, kan Greg hjælpe med at omsætte dataene til en politik på stiniveau, implementere kontrollerne i Cloudflare og robots.txt og etablere en reviewproces, der er knyttet til forretningsresultater. Drøft sitet og dets crawlerpolitik.
Relateret indhold på GrN.dk
- Synlighed i ChatGPT uden åben adgang: robots.txt er kun begyndelsen
- Styring af AI-crawlere på virksomhedswebsites: Beskyt indhold uden at forsvinde fra søgeresultaterne
- Crawlerpolitikken for AI har nu fået udsagnsord: Adskil søgning, RAG og træning
Har I brug for hjælp til denne type opgave?
Drøft jeres crawlerpolitik med Greg Kontakt Greg.